多相机阵列上板:边缘端 FPGA/MPSoC 怎么做实时 AI 推理
产线上四路相机同时拍,把画面全量回传到中心服务器再跑检测,带宽扛不住、延迟也压不下来。更合理的做法是把采集、预处理、推理全部下沉到板上,只把检测结果和压缩预览传出去。这篇按 PS/PL 分工把边缘端板载 AI 推理的架构、数据率预算和模型部署路径讲清楚。
一、为什么要把 AI 推理下沉到板上
多路视觉场景常见的旧做法:每路相机接交换机,原始视频流全部回传中心服务器,由服务器 GPU 集中跑检测。这条路在路数少时能跑,路数一多就暴露两个问题:一是未压缩视频的原始带宽极大,二是集中推理带来不可忽略的网络往返与排队延迟。
先算一笔原始带宽账:单路 1080p30、YUV422(每像素 2 字节)的原始数据率 = 1920×1080×2×30 ≈ 124 MB/s ≈ 995 Mb/s;四路叠加就是约 4 Gb/s 的未压缩流,还不算服务器侧的解码、排队和编码开销。中心集中式架构在这个量级下,链路成本和端到端延迟都很难做下来。
板载方案的思路反过来:相机画面先在本地板卡完成预处理和推理,对外只回传结构化结果(目标框、类别、置信度,每帧几 KB)和一路压缩预览,原始像素不出板。
二、板载 AI 推理的分层架构:PS 与 PL 各管什么
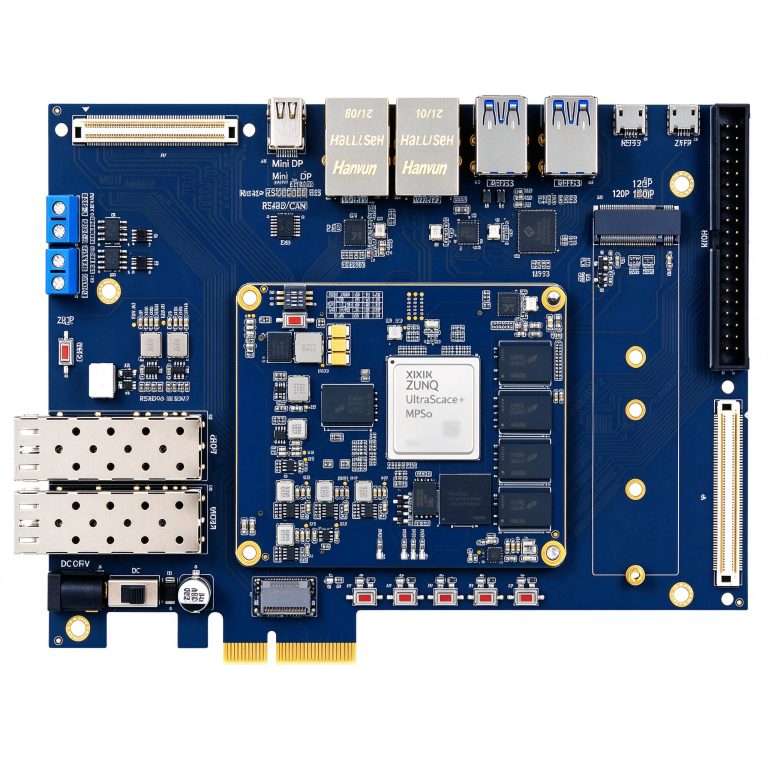
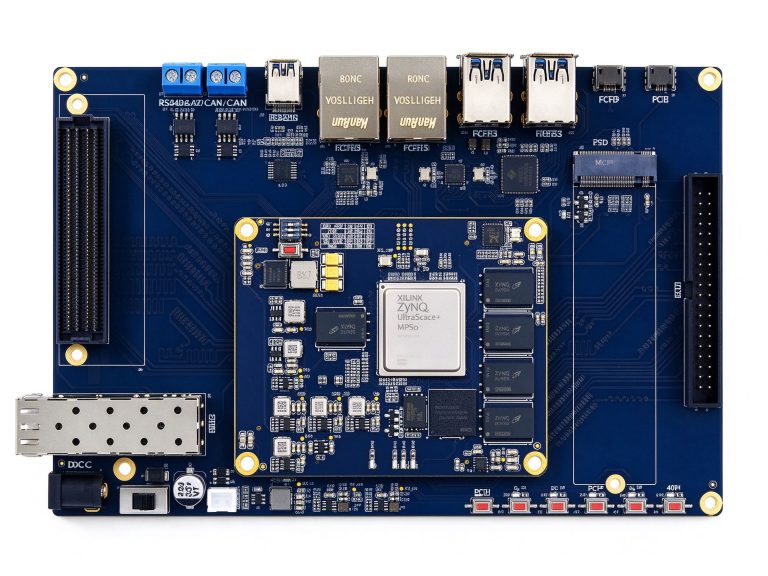
Zynq UltraScale+ MPSoC 把四核 A53 应用处理器(PS)和可编程逻辑(PL)放在一颗芯片里,正好对应”调度+系统”和”并行数据通路”两类工作。
1. PL:采集与预处理流水线
相机信号(MIPI CSI、USB 或 GigE)进入 PL 后,先由硬件并行完成去噪、缩放、色彩空间转换、格式归一化。这些操作天然是逐像素、可并行的,用 PL 流水线做比在 CPU 上串行快得多,也不占用 A53 的算力。
2. PL:量化模型的并行推理
模型推理的卷积、池化、激活在 PL 里用 DSP 切片阵列并行展开:权重放在片上 Block RAM/UltraRAM 或 PL 侧 DDR4,输入特征流经乘加阵列完成卷积,量化后(INT8)模型体积和访存压力大幅下降。PL 不跑操作系统,靠确定性流水线做到每帧固定节拍。
3. PS:调度、Linux 与结果上报
PS 侧四核 A53 跑 Linux,负责任务调度、与上位机通信、结果打包上报;内置 VCU 硬件编码器同时把一路预览帧做 H.264/H.265 压缩,经网口送回,人需要看画面时才拉这路低码率预览。
三、数据率预算:多路相机为什么不能全量回传
| 链路环节 | 单路 1080p30 | 四路合计 | 说明 |
|---|---|---|---|
| 未压缩原始(YUV422) | ~995 Mb/s | ~4.0 Gb/s | 全量回传服务器的旧做法 |
| 预处理后结构化结果 | 几 KB/帧 | 几 KB/帧 | 目标框+类别+置信度 |
| 压缩预览(H.264) | 2–4 Mb/s | 8–16 Mb/s | 仅人需要回看时传输 |
可以看到,板载方案把对外带宽从 Gb/s 级压到 Mb/s 甚至 Kb/s 级,中心服务器只收结果,不必再为每路相机预留解码和推理资源。这个”原始像素不出板、只出结果”的边界,就是边缘板载推理相对集中式方案的核心优势。
四、模型部署与板卡选择
1. 量化与模型裁剪先做
上板前先把模型量化到 INT8,配合裁剪和剪枝压缩权重体积;再把层间流水按片上存储和 DSP 容量切分,避免一次性把整张权重表搬进片上。部署工具链上,Vitis-AI 一类流程负责模型编译、量化和部署到 PL 加速单元,应用侧仍由 PS 的 Linux 托管。
2. 三档板卡按路数与算力选
边缘视觉板卡分工:入门原型 / 多路大算力 / 纯 FPGA 并行
- 入门边缘原型(DUUZ4EV,询价):XCZU4EV,192K 逻辑单元、728 DSP、内置 VCU,PS 4GB + PL 4GB DDR4,适合单到两路相机的边缘 AI 原型与 PYNQ 快速验证。
- 多路大算力(DUUZ5EV,询价):XCZU5EV,256K 逻辑单元、1248 DSP、16 对 GTH、FMC-LPC 扩展,路数更多、模型更重时的承接平台。
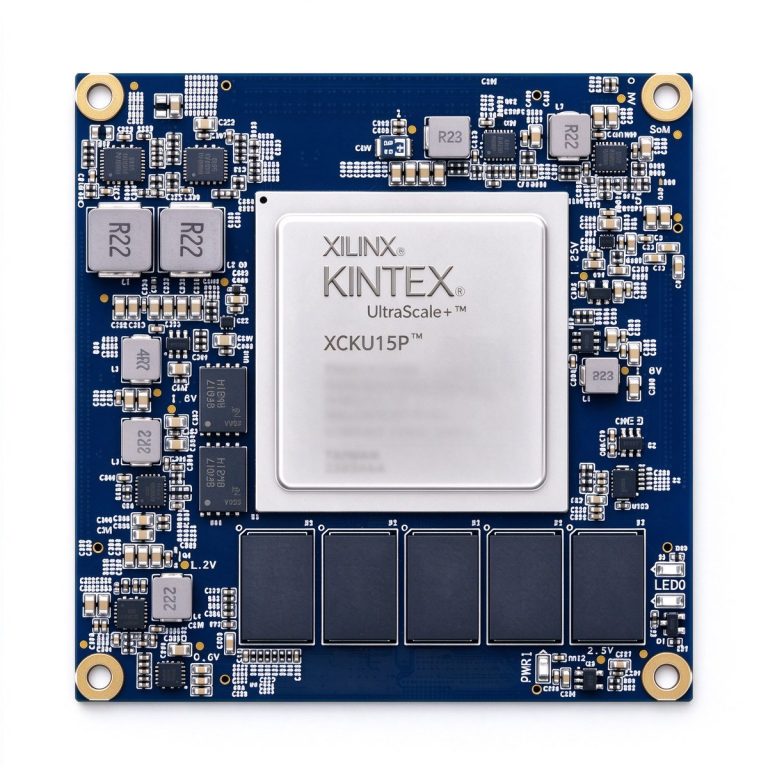
- 纯 FPGA 并行扩展(XCKU15P,¥15,999):Kintex UltraScale+ 核心板,多相机并行流处理与高速接口汇聚,适合不依赖 PS 系统、强调并行吞吐的场景。
边缘 AI 推理不是把服务器 GPU 换小,而是把”采集—预处理—推理—上报”整条链路在板上切清楚:PL 扛并行像素处理与量化卷积,PS 扛调度与通信,VCU 顺手把预览压缩好。原始像素不出板,只出结果,带宽和延迟两头就都松开了。