10G/25G 光纤回传:GTX/GTH 线速与 UDP offload 怎么规划
多路高速 ADC、雷达波束或视频流堆到一起,铜缆铜跑几米就到顶,PCIe 又出不了机箱。正确的回传姿势是用 FPGA 的 GTX/GTH 收发器直接驱动 SFP+/QSFP,在片内把 MAC、IP/UDP 协议栈卸载(offload)掉,只把净载荷经光纤线速送出去。这篇把 10G/25G 的线速、UDP 净载荷、链路预算和 FPGA 内部分工一次算清。
一、为什么高速数据要走光纤回传
板内用 PCIe、板间短距离用铜缆,但当采集节点分散、距离超过几米、单路数据又跑到几 Gb/s 以上时,铜缆和背板都会先碰到天花板:
1. 距离天花板:DAC 电缆(DAC)在 10G 下通常只支持 3~5 米,有源铜缆(AOC 也受限);单模光纤加光模块可以轻松走到 10km 量级,适合分布式采集阵面、远程雷达前端。
2. 带宽天花板:单路 1080p60、多路 SDR 中频、雷达 IQ 合并后常常超过 10Gb/s,千兆网和背板铜缆都装不下,需要 SFP+(10G)或 QSFP28(25G/100G)。
3. 时序与抗干扰:电磁环境复杂的工业现场,光纤电隔离、不受串扰和地环路影响,多节点共同时钟也更稳。
典型场景是:远端采集卡只负责 ADC 采样与预处理,把结果打包后经一根光纤回传到中心服务器;中心不做逐通道处理,只收聚合流。这时回传链路的线速和协议开销,直接决定能挂多少个节点。
二、10G/25G 线速与 UDP 净载荷预算(先算净载荷再接)
很多人按”10Gb/s 口”直接当成可用带宽,实际能送进应用层的是扣掉编码、帧间隙和协议头之后的净载荷。先看线速怎么来的:
| 项目 | 10G(SFP+) | 25G(QSFP28) | 说明 |
|---|---|---|---|
| 标称以太网速率 | 10.0 Gb/s | 25.0 Gb/s | MAC 侧有效速率 |
| 64b/66b 编码后线速 | 10 × 66/64 = <span class=”hl”>10.3125 Gb/s</span> | 25 × 66/64 = <span class=”hl”>25.78125 Gb/s</span> | 线路上的实际比特率 |
| MTU 1500 帧开销 | 前导/SFD 8B + 帧间隙 12B + Eth 14B + IP 20B + UDP 8B | 同左 | 每帧固定 ~62B 非载荷 |
| UDP 净载荷占比 | 1500/(1500+62) = <span class=”hl”>96.03%</span> | 同比例 ≈ 96.03% | 不含应用层重传 |
| UDP 净载荷速率(MTU1500) | 10 × 96.03% ≈ <span class=”hl”>9.60 Gb/s</span> | 25 × 96.03% ≈ <span class=”hl”>24.0 Gb/s</span> | 应用层真正收到的量 |
| Jumbo Frame(9000B)净占比 | 9000/9062 = 99.32% | 99.32% | 大包可把净速率提到 ~9.93 / ~24.8 Gb/s |
关键结论:10G 口按 MTU1500 跑 UDP,应用层只拿到约 9.6 Gb/s,不是 10 Gb/s。 设计节点容量时要用净载荷算:若每节点回传 2 Gb/s 有效数据,一条 10G 链路理论上限约 4~5 个节点(9.6 / 2,留余量),而不是 5 个满打满算。想逼近线速,就开 Jumbo Frame 把每帧固定开销摊薄。
误码率(BER)与链路预算
光纤链路不是接上就通,要先算光功率预算:发送光功率 − 接收灵敏度 = 链路余量,余量里要扣掉光纤衰减(单模 1310nm 约 0.35 dB/km)、熔接与连接器损耗(每个接头约 0.5 dB)。SR 多模 850nm 受距离和 OM3/OM4 限制,LR 单模 1310nm 可到 10km。规范链路 BER 要求优于 1e-12;25G 普遍加 RS-FEC 前向纠错,把原始 1e-5 量级误码纠到 1e-15,预算要把 FEC 编码增益也算进去。
三、FPGA 内部怎么分工
1. GTX/GTH 收发器驱动光模块
7 系列 GTX 最高线速 10.3125 Gb/s,正好对应 SFP+ 10G;UltraScale/UltraScale+ 的 GTH、GTY 可到 16G 以上并支持 25G。收发器负责串行化/解串、8b/10b 或 64b/66b 编码、时钟恢复,外部只留 SFP+/QSFP28 的高速差分对与光模块管理 I2C(DDM 读光功率)。
2. MAC 与帧处理
收发器之上是 10G/25G Ethernet MAC,完成帧定界、CRC 校验、流控(PAUSE)。接收方向丢弃 CRC 错误帧、按目的 MAC 过滤;发送方向做帧封装与间隙填充。这一层是确定性流水线,适合全硬件跑。
3. UDP offload 协议卸载引擎
让 CPU 逐包封 IP/UDP 是 10G 下的瓶颈。FPGA 内做协议 offload:源/目的 IP、端口、校验和由硬件填好,用户只把净载荷写进 DMA 缓冲,引擎自动加 Ethernet/IP/UDP 头、算校验和、按 MTU 分片发出。CPU 不参与封包,只在初始化时配一次地址表,这就是”协议栈卸载”。
4. 误码统计与链路监控
片内计数器统计 CRC 错误帧、丢帧、FEC 纠错次数,周期性经管理通道上报;光模块 DDM 的发射功率、接收光功率、温度也一并采集,链路余量下降时提前告警,而不是等图像花了才排查。
四、工程案例:多路采集经 10G 光纤回传中心
某分布式采集系统由 4 个远端节点组成,每节点合并两路 SDR 中频与一路视频,有效回传约 2.2 Gb/s;中心经一条 10G 光纤汇聚,开 Jumbo Frame 后净载荷约 9.9 Gb/s,4 节点合计 8.8 Gb/s 留有余量。协议全部在 FPGA 内 UDP offload,主机只收净载荷。
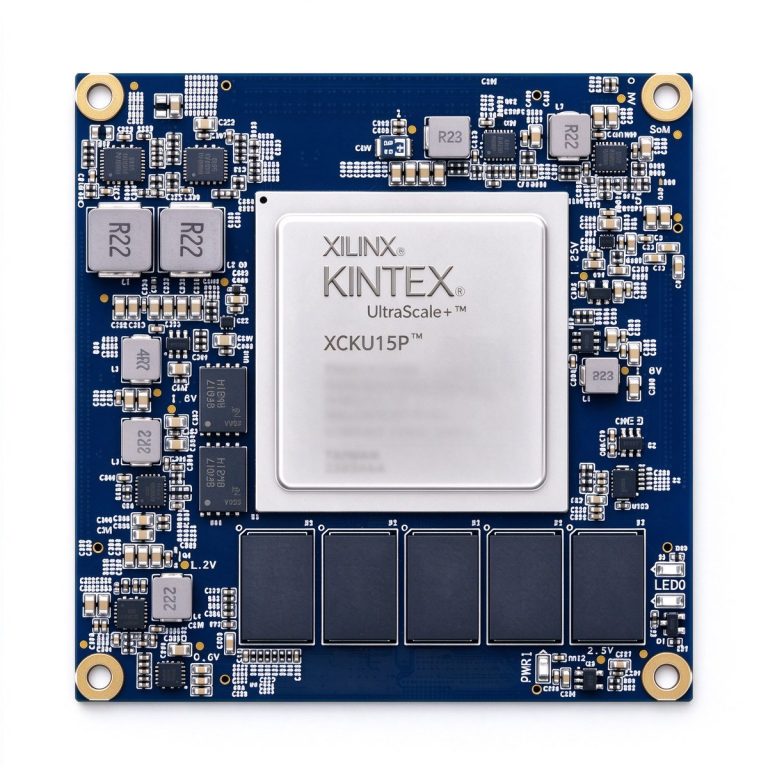
- 高带宽收发方案(XCKU15P / Kintex UltraScale+):GTY 收发器裕量足,可同时跑 25G 或多通道 10G 汇聚,适合节点数多、要升级到 25G/100G 的主汇聚节点。
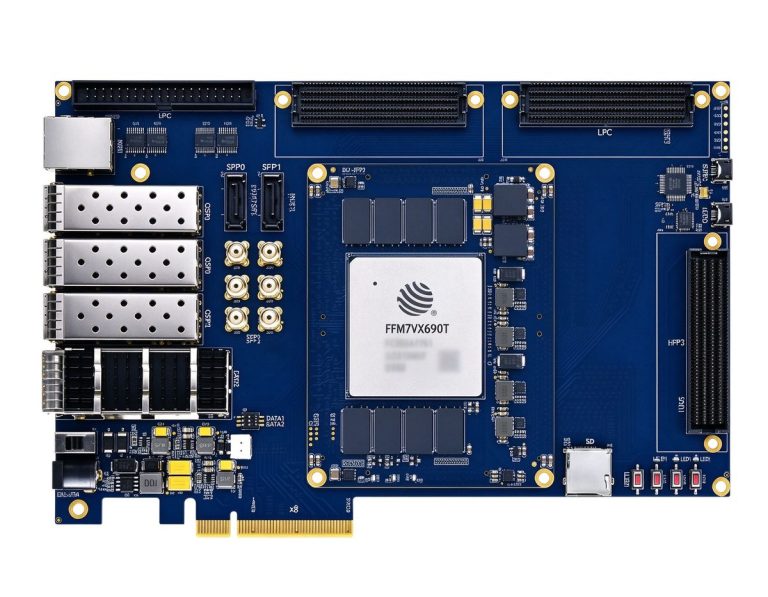
- 大容量聚合方案(DUF7690T / JFM7VX690T):逻辑与片上 RAM 充足,能放下多路 MAC、UDP 卸载引擎和大缓冲队列,适合中心侧做多节点聚合与线速转发。
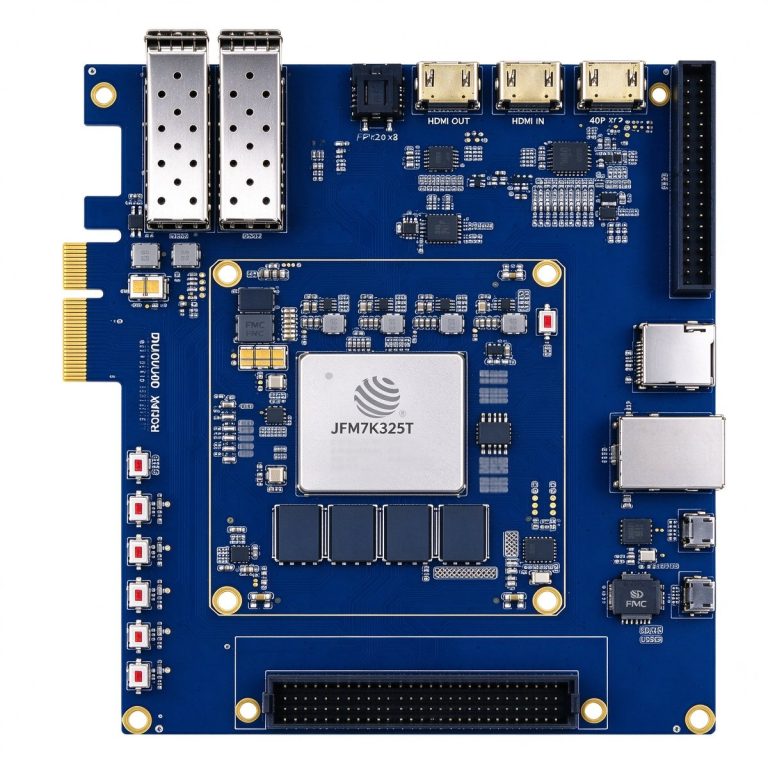
- 10G 原型入门(DUK7325T / JFM7K325T):7 系 GTX 跑满 10G 线速,资源成本均衡,适合单节点 10G 回传原型验证与中低端产品先跑通链路。
光纤回传的本质,是让 FPGA 的收发器和硬件协议栈替 CPU 把”线速发出去”这件事做完。记住两个数:10G 口 MTU1500 净载荷约 9.6 Gb/s、25G 约 24 Gb/s;按净载荷而不是标称速率去排节点数,链路预算和 BER 提前算好,回传才不会在现场掉速。