医疗超声波束合成:128 通道信号链与数据率预算
一台 128 通道的彩色超声探头,每通道用 12 bit、40 MS/s 的 ADC 采样,原始数据率约 7.7 GB/s——这个量级 CPU 根本接不住,更没法实时成像。正确的做法是把波束合成、检波、降采样全部放在 FPGA 里先做掉,只把压缩后的成像数据送进主机。这篇文章把 128 通道的信号链逐段拆开,算清楚每一级的数据率预算,讲明白 FPGA 在中间到底承担了什么。
一、超声成像的完整信号链
从探头阵列到屏幕上的灰度图像,信号要走一条很长的链,FPGA 位于模拟前端之后、主机成像之前:
1. 探头阵列(128 阵元):发射超声波后接收组织回波,每一个阵元对应一条独立通道。
2. 模拟前端(AFE):TGC 时间增益补偿 → 带通滤波 → 可变增益放大 → ADC 数字化。
3. FPGA 波束合成:逐通道可编程延迟、加权、叠加成扫描线,完成动态聚焦。
4. IQ 解调 + 降采样 + 包络检波:把高频 RF 信号压成带幅度的灰度数据。
5. 扫描转换 + 帧缓冲 + PCIe 上传:极坐标扫描线转直角坐标,送主机做 DSC/色彩映射与显示。
之所以必须由 FPGA 承担第 3、4 步,原因很直接:128 条通道要在微秒级内完成对齐、延迟和加权求和,且每一路延迟随深度动态变化。这是高度并行、逐通道、确定性时序的工作,软件跑在通用 CPU 上既并行度不够,也满足不了实时帧速率。
二、128 通道数据率预算(先算清楚再接)
预算从单通道 ADC 开始往上乘。以 12 bit、40 MS/s 的 ADC 为例:
| 环节 | 单通道数据率 | 128 通道合计 | 说明 |
|---|---|---|---|
| ADC 原始采样 | 12 bit × 40 MS/s = 480 Mb/s(60 MB/s) | 128 × 480 = 61440 Mb/s ≈ 61.4 Gb/s(7.68 GB/s) | 前端进 FPGA 的原始峰值 |
| 波束合成(延迟叠加) | 128 通道加权求和 → 1 条扫描线 | 合成后不再是 128 路并行 | 并行度在这一步被压缩掉 |
| IQ 解调 + CIC/FIR 降采样 | RF 40 MS/s → 等效 ~10 MS/s 复信号 | 单路约 20 MB/s(复 12 bit) | 抽取后降到原始的 1/4 以下 |
| 包络检波 + 对数压缩 | 8 bit 幅度,~10 MS/s | 单路约 10 MB/s | 动态范围压缩到 40~60 dB |
| PCIe 上传主机 | — | 256 扫描线 × 60 帧/s × 8 bit ≈ 122 MB/s | CPU 只需处理这一级 |
关键结论:压缩发生在 FPGA 内部。 进 FPGA 的是 61.4 Gb/s 的原始并行流,出 FPGA、能送进主机的只有约 122 MB/s 的灰度帧数据。压缩比超过 60 倍,这 60 倍全靠波束合成把 128 路并成 1 路、再靠降采样和检波把高频 RF 压成幅度包络。如果跳过 FPGA 直接把 7.68 GB/s 原始流推给 CPU,无论是内存带宽还是 PCIe 都扛不住。
帧速率和扫描线数量的关系
波束合成阶段,每一条扫描线都要重新做一次 128 通道延迟叠加。设一帧 N 条扫描线、帧速率 F,则 FPGA 每秒要完成 N×F 次合成。以 N=256、F=60 帧/s 计,每秒需合成 256 × 60 = 15360 条扫描线,每条线叠加 128 个带权延迟样本——这正是评估 FPGA 乘法器(DSP)和片上 RAM(延迟线 FIFO)用量的起点。
三、FPGA 内部怎么分工
1. 多通道同步采集与通道对齐
128 通道通常分多片 AFE,经 JESD204B 或并行 LVDS 进 FPGA。第一关是通道偏斜补偿:各通道走线长度不一致,进 FIFO 前要把采样点对齐到同一时钟基准,否则延迟叠加会出现相位错位,图像出现旁瓣和假影。
2. 动态聚焦延迟叠加(Delayed-and-Sum)
每个阵元到聚焦点的距离不同,回波到达时间就不同。FPGA 用可编程延迟线(深度可调的 FIFO 或抽头延迟)逐通道补偿这个时间差,再乘以 apodization(切趾)权重求和。聚焦深度随时间门移动,延迟参数每一段都要刷新,这部分消耗大量片上 BRAM 和 DSP 做乘法累加。
3. IQ 解调、降采样与包络检波
合成后的 RF 扫描线先做正交解调(I/Q 两路混频),再用 CIC + FIR 级联抽取把采样率降下来;接着 Hilbert 变换求包络,最后对数压缩把回波的大动态范围映射成 8 bit 灰度。这一级是典型的流水线滤波运算,DSP 资源利用率高但并行度低。
4. 扫描转换、帧缓冲与上传
极坐标的扇形扫描线要重采样成直角坐标的矩形像素,写进 DDR3/4 帧缓冲,再由 PCIe DMA 把整帧送主机。这一级关注的是 DDR 读写带宽和 DMA 引擎,而不是 DSP 吞吐。
四、工程案例:便携彩色超声前端选型
某便携彩超前端采用 128 通道 AFE,RF 采样 40 MS/s、12 bit。波束合成需并行处理 128 路延迟线和加权乘法,叠加血流多普勒通道。按上面预算,原始 61.4 Gb/s 在 FPGA 内压到约 122 MB/s 灰度帧,PCIe Gen2 x4 净带宽足够承载。
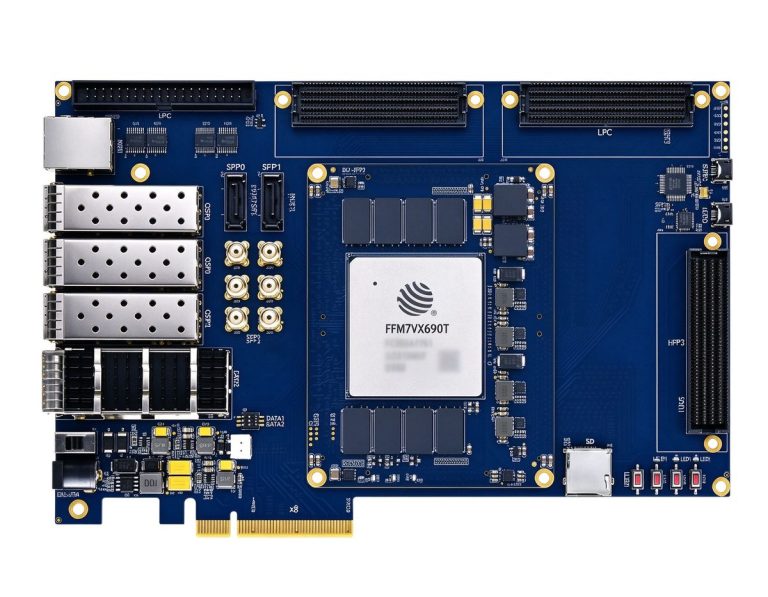
- 大容量方案(DUF7690T / JFM7VX690T):逻辑资源与片上 RAM 充足,能同时放下 128 路延迟线 FIFO、灰度合成和多普勒通道,适合满配 128 通道 + 高帧率。
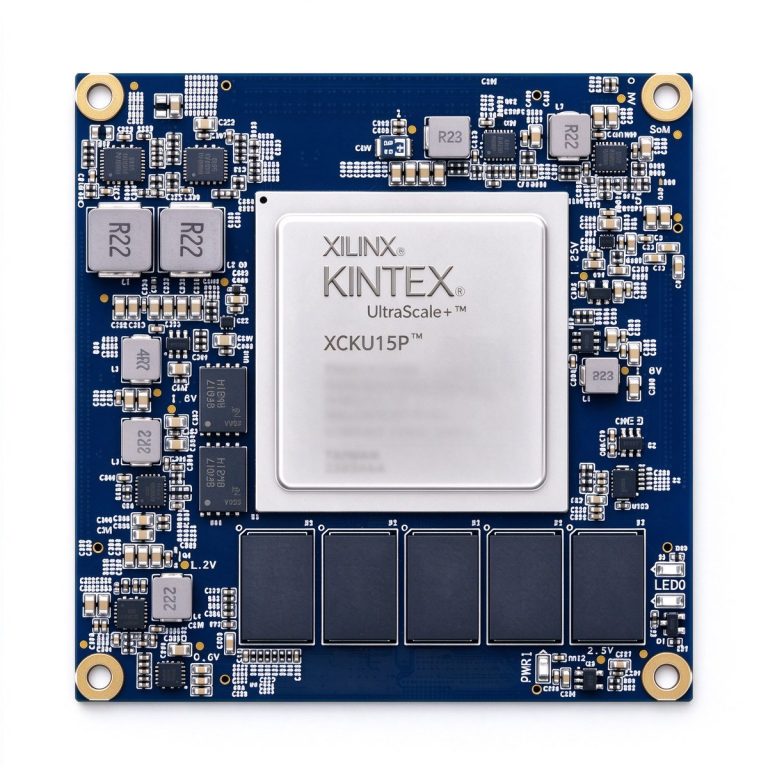
- 高通道扩展方案(XCKU15P):高速收发器与多通道 LVDS 汇聚能力强,适合通道数进一步扩展或需要把 AFE 数据经光纤回传的分布式探头。
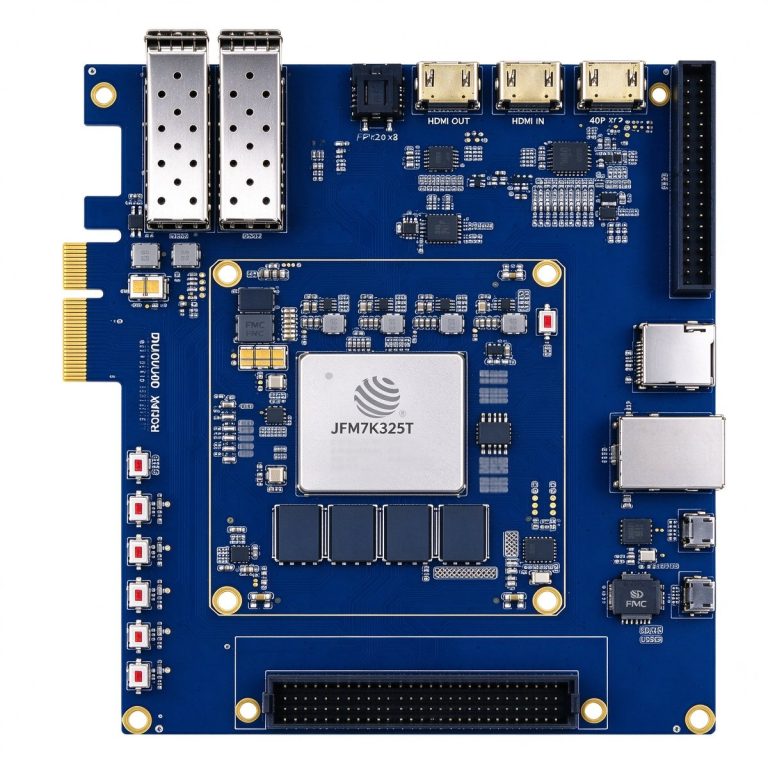
- 中端入门方案(DUK7325T / JFM7K325T):资源和成本均衡,适合 64~128 通道灰度成像的原型验证与中低端产品,先用它跑通延迟叠加和检波链路再上大容量平台。
超声成像的本质,是把 128 路高速原始回波,在 FPGA 里用并行延迟叠加”算”成一条扫描线。数据率预算算清楚——前端 61.4 Gb/s、上传 122 MB/s——你才知道哪一步必须放在片内、哪一步可以交给主机。FPGA 在医疗超声里不是加速卡,而是成像本身。