TSN 时间敏感网络:确定性以太网与帧抢占怎么落地
标准以太网的”尽力而为”在工业控制里不够用——同一条网线上,一段大文件传输就能把一个运动控制帧堵出几毫秒。TSN(Time-Sensitive Networking,IEEE 802.1)用时间同步、时间门控和帧抢占三件事,把以太网改造成可预测、可计算时延的网络。这篇文章把它拆成能算的数字,以及在 FPGA 板卡上怎么落地。
为什么标准以太网在工业控制里”不可预测”
普通以太网用 CSMA/CD(后来是全双工无冲突交换),本质是”谁先来谁先发”。问题不在于平均时延,而在于最坏时延不可控:
- 一个 1Gbps 端口上,一个 1518 字节的大帧正在发送;
- 与此同时,一个 64 字节的运动控制高优先级帧到达交换机端口;
- 交换机不能打断正在发送的大帧,控制帧只能排队等它发完。
这段”排队等待”就是抖动的来源。在办公网络里无所谓,但在多轴运动控制、机器人关节、伺服联动里,一个控制周期通常是 125µs 甚至更短,控制帧晚到几百微秒,轴之间就不同步了。
TSN 不是换一种网线,而是在以太网上叠加一组确定性调度规则,让”最坏情况”可设计、可计算。
TSN 到底解决什么:四组标准拼出确定性
TSN 不是单一协议,而是 IEEE 802.1 工作组下一组标准的集合,常用的四块:
| 子标准 | 解决什么 | 通俗理解 |
|---|---|---|
| 802.1AS(gPTP) | 全网时间同步 | 所有交换机和节点共享一个统一时钟,偏差控制在 1µs 内 |
| 802.1Qbv(TAS 时间感知整形器) | 流量按时间表发送 | 每个端口的队列有一张”开门时间表”,什么时候放实时流量、什么时候放普通流量,精确到微秒 |
| 802.1Qbu / 802.3br(帧抢占) | 高优先级帧不被大帧堵 | 大帧发到一半可以被打断、先插队,再续传 |
| 802.1Qat / 802.1Qav | 带宽预留与队列管理 | 给实时流预留固定带宽,普通流量不会挤爆它 |
可以把 TSN 想象成给网线修了一条”专用公交道”:先让所有路口时钟对齐(gPTP),再规定公交在几点几分必须走专用道、社会车辆在别的时间段走(TAS),遇到大货车挡道时公交车能从旁边缝隙插过去(帧抢占)。
三个关键数字:把时延从毫秒压到微秒
一帧在 1Gbps 线上到底占多少时间
先把物理层算清楚。1Gbps 即每秒 10^9 bit,传输时延 = 数据量 bit ÷ 10^9。
| 帧类型 | 字节数 | bit 数 | 1Gbps 传输时延 |
|---|---|---|---|
| 最小以太网帧 | 64 B | 512 bit | 0.512 µs |
| 普通帧 | 512 B | 4096 bit | 4.10 µs |
| 标准最大帧 | 1518 B | 12144 bit | 12.14 µs |
| 巨型帧 | 9000 B | 72000 bit | 72.0 µs |
也就是说,一个最大标准帧会独占线路约 12.1µs。在没有帧抢占时,高优先级控制帧最坏要等满这 12.1µs,再加上交换机转发和排队,抖动很容易冲到几百微秒甚至毫秒级。
帧抢占到底省了多少阻塞
802.1Qbu/802.3br 的做法:把长帧在 64 字节边界切成两段。当高优先级帧到达时:
- 若正在发送的长帧已发完第一个 64 字节(碎片检查点),立即打断它;
- 高优先级帧完整发送(最坏 0.512µs);
- 被打断的长帧记录断点,稍后续传。
对比一下最坏阻塞:
- 无抢占:控制帧最坏等一个完整大帧 ≈ 12.14µs;
- 有抢占:控制帧最坏只等不到一个碎片(≤64B,0.512µs)+ 自身发送时间。
这段从约 12µs 压到约 1µs 的差距,就是 TSN 能把控制周期做到微秒级的关键。
gPTP 时间同步怎么对齐
TAS 的”时间表”全网必须共用同一时间,否则各开关各开各的门。802.1AS(gPTP)通过链路层时间戳交换,让主从节点对齐:
- 主时钟周期性发同步报文;
- 每一跳交换机都用硬件打时间戳,记录报文进/出时刻,校正链路不对称时延;
- 端节点根据主时钟调整本地时钟。
工程上 gPTP 端到端偏差通常做到 ±1µs 以内,这正是 TAS 时间表能排到微秒粒度的前提。没有好的同步,后面的调度全是空谈。
FPGA 上怎么落地 TSN:从 MAC 到时间门控
TSN 的”时间戳”和”门控”最吃硬件精度,CPU+软件协议栈做不到微秒级,这正是 FPGA 的位置。一条典型 FPGA TSN 节点链路是:
1. PHY:支持 100M/1G/2.5G/5G 多速自协商,且支持帧抢占(802.3br)的破碎/重组;
2. 以太网 MAC:硬 MAC 或软 MAC,输出带时间戳的数据流;
3. TSN IP 核:在 FPGA 逻辑里实现 gPTP 从时钟、TAS 时间门控调度器、帧抢占/重组;
4. 业务逻辑:运动控制报文、传感器数据、普通业务分别进不同队列。
关键点在于:时间戳必须打在 PHY/MAC 边界的硬件里,而不是软件收包后再记录——后者误差就是几十微秒。FPGA 能把”报文到达→打时间戳→查门控表→决定何时发送”整条路径做进同一时钟域,这是它做 TSN 节点相对通用 CPU 网关的核心优势。
选型:三档板卡怎么配 TSN 节点
不同 TSN 场景对逻辑资源和收发器数量要求不同,按预算和端口数选:
| 板卡 | FPGA 平台 | 适合的 TSN 角色 | 为什么选它 |
|---|---|---|---|
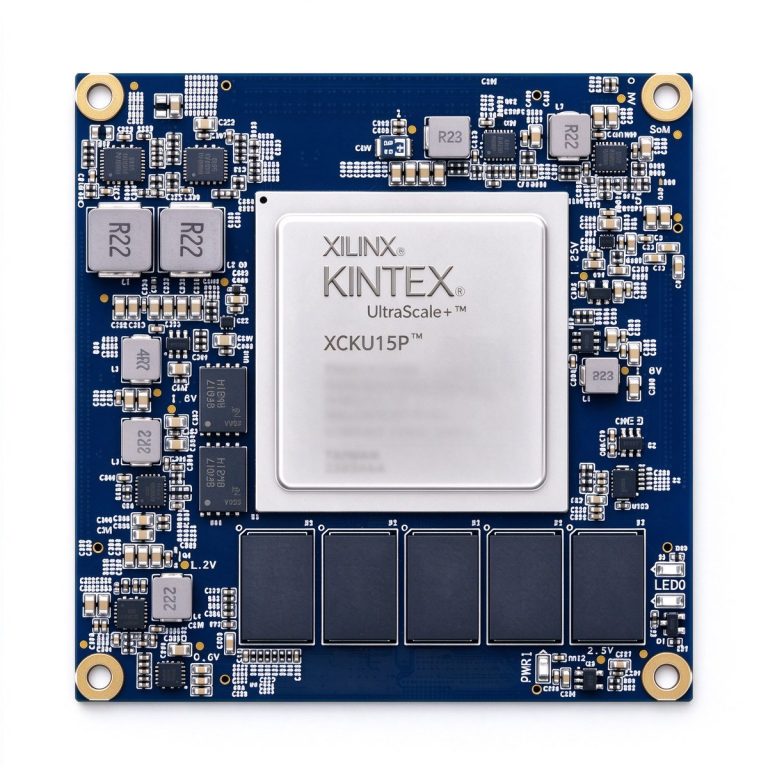
| XCKU15P 核心板 | Kintex UltraScale+ | 多口 TSN 汇聚/边缘网关 | 逻辑资源充裕,带 GTH 收发器与硬 Tri-Mode MAC,可同时跑 gPTP 从时钟 + 多路 TAS 调度 + 业务加速 |
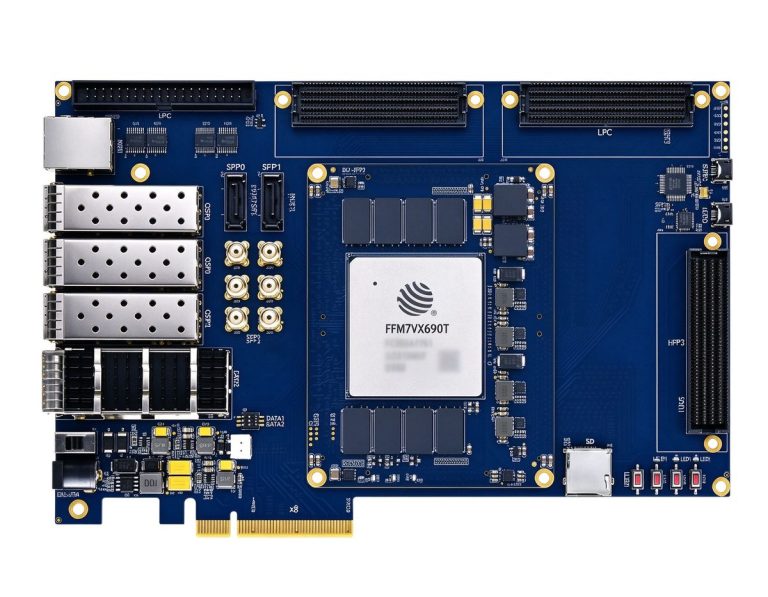
| DUF7690T | 复旦微 JFM7VX690T(兼容 XC7VX690T) | 高可靠/国产化 TSN 节点 | Virtex-7 级资源,工业级温度,适合对供应链和可靠性有要求的国产化产线 |
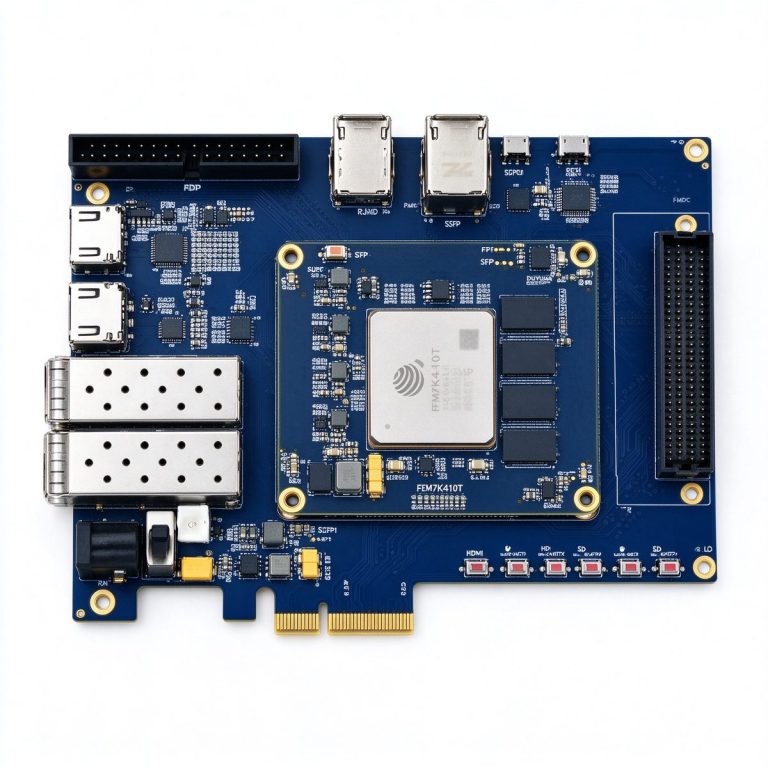
| DUK7410T | 复旦微 JFM7K410T(兼容 XC7K410T) | 单/双口 TSN 终端节点 | Kintex-7 级,成本更可控,跑一个 gPTP 从口加单路 TAS 足够,适合批量终端 |
一个常见配比:产线用 DUK7410T 做现场终端,DUF7690T 做工位国产化网关,XCKU15P 做整条线的多口 TSN 汇聚节点,普通 IP/视频流量与实时控制流量在同一条网线里被 TSN 队列分开。
工程案例:把一条混线改成 TSN
某设备原来用两条网线:一条跑 PLC 与伺服的实时控制,一条跑相机图像和日志。改造后合到一条千兆线,用 TSN 分开:
- 实时控制帧走 TAS 专用门控,周期 125µs,带宽预留约 10%;
- 相机大流量走普通队列,靠帧抢占保证它绝不会堵住控制帧;
- gPTP 把 4 个伺服节点时钟对齐到 1µs 内。
改造后实测:控制帧最坏抖动从原来的约 800µs 降到 3µs 以内,网线从两条减到一条,交换机端口和布线成本同步下降。
确定性不是把网络变快,而是把”最坏情况”从不可知变成可计算——这正是 FPGA 把时间做进硬件的价值。
延伸阅读
- [10G/25G 光纤回传:远距离高带宽链路怎么搭](/article/fiber-backhaul-10g-25g/)
- [FMC 子卡生态:板卡怎么扩展专用接口](/article/fmc-mezzanine-ecosystem/)
- [PCIe 带宽规划:主机与板卡之间的带宽怎么算](/article/pcie-bandwidth-planning/)