PCIe 带宽规划:Gen3 x4 到 x16 到底能跑多少净带宽
PCIe 带宽的账,比接口规格表上的数字复杂得多——理论带宽、编码开销、协议开销、DMA 效率、DDR 瓶颈,每一层都在吃掉你看到的”16 GB/s”。这篇文章从 Gen3 x4/x8/x16 三档算起,算到 DDR 与 DMA 的匹配,给出一套可复用的净带宽估算方法。
一、先分清三层带宽:理论值、编码后、净带宽
看到规格表上”PCIe Gen3 x16″,直觉是 16 GB/s。这个数字其实是原始比特率,不是你系统里真正能用的带宽。中间隔着两层损耗:
| 层级 | Gen3 x16 计算 | 结果 | 含义 |
|---|---|---|---|
| ① 原始比特率 | 16 通道 × 8.0 GT/s | 128 Gb/s | 链路上跑的原始符号率 |
| ② 编码后带宽 | 128 × 128/130(Gen3 用 128b/130b 编码) | ≈ 126 Gb/s ≈ 15.75 GB/s | 扣除编码开销后,有效载荷的数据率 |
| ③ 实际净带宽 | 15.75 × 传输效率(80%~90%) | ≈ 12.6 ~ 14.2 GB/s | 扣除 TLP 头、DMA 描述符、中断后的真实可用带宽 |
Gen3 每通道 8.0 GT/s,128b/130b 编码开销仅 1.5%,这是 Gen3 比 Gen2(8b/10b 编码开销 20%)效率高的关键原因。各宽度对比:
| PCIe 宽度 | 原始比特率 | 编码后带宽 | 典型净带宽(大块 DMA) |
|---|---|---|---|
| Gen3 x4 | 32 Gb/s | ≈ 3.94 GB/s | ≈ 3.2 ~ 3.5 GB/s |
| Gen3 x8 | 64 Gb/s | ≈ 7.88 GB/s | ≈ 6.3 ~ 7.1 GB/s |
| Gen3 x16 | 128 Gb/s | ≈ 15.75 GB/s | ≈ 12.6 ~ 14.2 GB/s |
| Gen2 x8(对比) | 40 Gb/s | ≈ 4.0 GB/s(8b/10b 编码) | ≈ 3.2 ~ 3.6 GB/s |
二、协议开销吃掉多少:TLP、payload 与读写方向
编码后带宽 ≠ 实际净带宽。PCIe 事务层数据包(TLP)本身有开销:每个 TLP 都带 12~20 字节的头部,payload 越大,头部占比越低,效率越高。
Payload 大小直接决定效率
| Payload 大小 | TLP 头占比 | 传输效率 | 典型场景 |
|---|---|---|---|
| 4 KB(最大) | ≈ 0.4% | ≈ 90%+ | 大块连续 DMA 采集、视频流 |
| 512 B | ≈ 3% | ≈ 85~88% | 一般数据回传 |
| 64 B | ≈ 25% | ≈ 55~65% | 寄存器读写、小包控制 |
读比写更慢:Completion 的隐藏代价
PCIe 写事务是”fire and forget”,发送方不管对端是否收到;PCIe 读事务必须等对端返回 Completion TLP,一来一回,时延和带宽都翻倍。实测中:
- 大块连续写: 可达编码后带宽的 88~92%
- 大块连续读: 通常只有 80~85%(Completion 排队、开销)
- 读写混合: 方向切换会带来链路停顿,效率再降 5~10%
所以工程规划里,建议按“净带宽 = 编码后 × 80%”做保守估算,而不是按 90% 以上的理想值留余量。
三、DDR 才是真正的天花板
PCIe 链路够快,不代表系统能跑满——数据进出 FPGA 都要过 DDR,DDR 带宽往往是最先被撞破的那堵墙。
DDR 带宽怎么算
DDR 带宽 = 数据总线宽度 × 数据率 / 8。以笃远常用板卡为例:
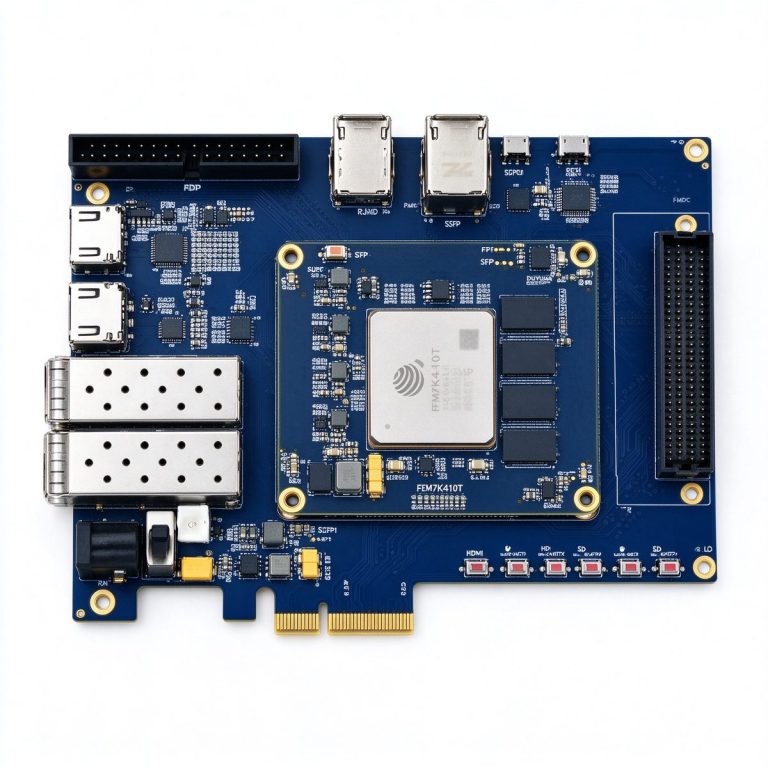
- DUK7410T: 4GB DDR3,64-bit 数据总线,1866 Mbps → 64 × 1866 / 8 ≈ 14.9 GB/s
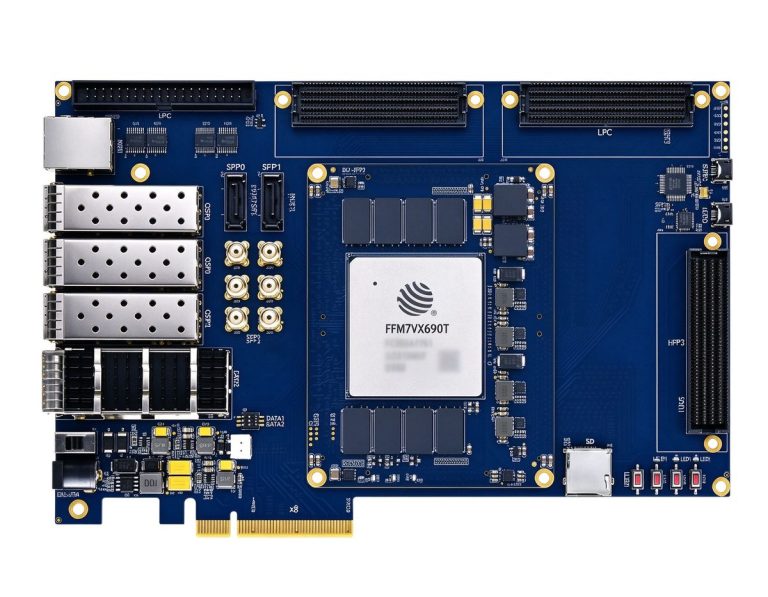
- DUF7690T: 4GB DDR3,64-bit,1866 Mbps → ≈ 14.9 GB/s
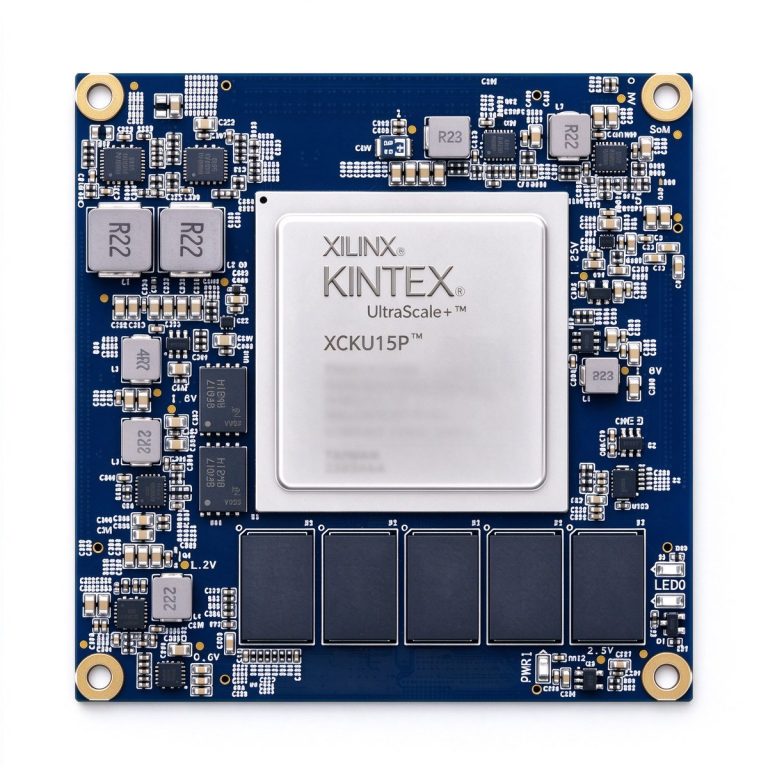
- DUKU15P: 8GB DDR4 ECC,64-bit 数据总线(+8-bit ECC)→ 按 2400 MT/s 估算 ≈ 19.2 GB/s
数据流是双向的:读写双倍占用
设想一个高速采集场景:ADC 数据经 FPGA 处理后,通过 PCIe 写回主机。这条数据流要过两次 DDR:
- FPGA 接收数据 → DDR 写(帧缓冲)
- FPGA 处理完 → DDR 读(取出发送)
- DDR 总占用 = 写带宽 + 读带宽
如果 PCIe x8 Gen3 净带宽 7 GB/s,意味着 DDR 要同时写 7 GB/s + 读 7 GB/s = 14 GB/s——这已经逼近 DDR3 14.9 GB/s 的物理极限,留给 FPGA 算法运算的带宽所剩无几。这就是为什么 x8 Gen3 配 DDR3 是”黄金组合”,再往上到 x16 就必须上 DDR4。
| 板卡 | PCIe 规格 | 编码后带宽 | DDR 配置 | DDR 带宽 | 匹配判断 |
|---|---|---|---|---|---|
| DUK7410T | Gen2 x8 | ≈ 4.0 GB/s | 4GB DDR3 64bit | ≈ 14.9 GB/s | PCIe 是瓶颈,DDR 宽裕 |
| DUF7690T | Gen3 x8 | ≈ 7.88 GB/s | 4GB DDR3 64bit | ≈ 14.9 GB/s | 读写各 ~7.5 GB/s,刚好打平 |
| DUKU15P | Gen3 x16 | ≈ 15.75 GB/s | 8GB DDR4 64bit | ≈ 19.2 GB/s | PCIe 满载时 DDR 接近上限 |
四、三步估算法:算清你的项目需要多少带宽
方法论 · 01:PCIe 带宽需求估算三步走
第一步:算净需求。 把数据源的原始数据率加起来,这是必须搬走的最小量。
第二步:乘冗余系数。 按”净需求 × 1.2~1.5″留余量(考虑协议开销、突发、双工)。
第三步:反推 PCIe 宽度。 按”编码后带宽 ≥ 冗余后需求”选规格,再验证 DDR 是否跟得上。
用三个常见场景验证:
| 场景 | 原始数据率 | 冗余后需求 | 推荐 PCIe | 理由 |
|---|---|---|---|---|
| 高速数据采集(2ch × 250MSPS × 14bit) | ≈ 875 MB/s | ≈ 1.1 ~ 1.3 GB/s | Gen3 x4(3.94 GB/s) | 余量充足,DDR 完全无压力 |
| 4K60 视频采集与处理(10bit 4:2:2) | ≈ 1.5 GB/s | ≈ 1.8 ~ 2.3 GB/s | Gen3 x8(7.88 GB/s) | 多路视频或拼接场景留足空间 |
| AI 推理特征图批量回传 / 8K 视频流 | ≈ 10 ~ 12 GB/s | ≈ 12 ~ 18 GB/s | Gen3 x16(15.75 GB/s) | 必须配 DDR4,否则 DDR 先撞顶 |
一条经验法则:选 PCIe 宽度时,按”净需求 × 2″反推,留足一倍余量。带宽不够可以升,但宽度不够只能换板重设计。
五、笃远三款 PCIe 平台怎么选
DUK7410T(¥9,999)——成本敏感型采集与处理
复旦微 JFM7K410T,PCIe Gen2 x8 硬核,编码后约 4 GB/s。配合 FMC HPC 子卡做高速 ADC 采集,或者 HDMI 4K 视频处理,PCIe 带宽不是瓶颈的场景从这块起步最划算。
DUF7690T(¥24,999)——主力采集与复合处理
复旦微 JFM7VX690T,PCIe Gen3 x8 硬核,编码后约 7.88 GB/s。配合 4GB DDR3,读写双向约 7.5 GB/s,刚好匹配 x8 的满带宽。多通道采集、雷达信号处理、视频拼接主力平台。
DUKU15P(¥15,999)——高端数据回传与 100G 互联
AMD Kintex UltraScale+ XCKU15P,PCIe Gen3 x16 硬核,编码后 15.75 GB/s,配合 8GB DDR4 ECC。同时集成 56 对高速收发器(24× GTY 28G + 32× GTH 16G)和 4×100G 以太网硬核,是需要大带宽 PCIe 回传 + 高速网络复合的旗舰选择。
PCIe 带宽从来不是”接口速度”,而是”接口 × 内存 × DMA”三者中最短的那块板——规划时先算 DDR 能不能跟上,再谈 PCIe 跑多快。
>
—— 笃远电子研发团队