用 FPGA 做实时工业视觉检测:从 GigE 相机到缺陷标定的完整通路
一条产线缺陷检测通路,从相机像素到剔除信号,FPGA 在哪些环节不可替代?这篇文章先算清整条数据流的带宽账,再拆解 FPGA 在视觉通路里的四个角色,对比传统算法与深度学习的实时性差异,最后用一个 PCB 焊点 AOI 工位的案例给出可落地的硬件选型。
一、先算带宽账:一条 1080p60 产线通路的数据流
工业视觉的第一道坎不是算法,是带宽。先把一条最普通的产线通路——一台 1080p、60fps 的 GigE Vision 相机——的数据率算清楚:
| 输出格式 | 数据率计算 | 结果 | 能不能走千兆网口 |
|---|---|---|---|
| 8bit Bayer(最常见) | 1920 × 1080 × 8 bit × 60 | ≈ 995 Mb/s ≈ 124 MB/s | 刚好卡满 1Gbps 的 99.5%,勉强 |
| 12bit Bayer(HDR/弱光) | 1920 × 1080 × 12 bit × 60 | ≈ 1.49 Gb/s ≈ 187 MB/s | 超千兆,必须 2.5G/10G 口或 CoaXPress |
| 4 路 8bit 相机 | 995 Mb/s × 4 | ≈ 4 Gb/s ≈ 500 MB/s | 需 4× 千兆汇聚或万兆上行 |
如果把这些原始帧整帧直传 CPU 或 GPU,每一路每秒都在搬 124~187 MB 数据;四路就是 500 MB/s。到了 CPU 侧还要再做一帧完整图像的处理——带宽和算力两头烧。而缺陷检测真正需要的,只是”哪些区域异常、什么类型、坐标在哪”,这些结果往往只有 几百字节。
关键在于:像素在哪里被处理掉,决定整条通路的成本
把原始帧搬走再处理,是”搬运工”思路;在像素流经的地方就地处理,才是”流水线”思路。前者每增加一路相机就多一份带宽和算力开销,后者只增加一份处理逻辑。
二、FPGA 在视觉通路里的四个角色
角色 1:接口接入与多相机同步
GigE Vision / CoaXPress 的协议解析、相机参数配置、触发信号管理,由 FPGA 的 MAC 层与触发逻辑直接承担。多台相机可以锁到同一个硬件触发时钟,保证不同视角的帧在同一时刻曝光——这是软件方案最难做到的确定性。
角色 2:图像预处理(去噪、增益、Bayer 插值)
去噪、白平衡、增益、Bayer 插值、ROI 提取,都是逐像素操作。FPGA 流水线天然一个时钟一个像素,1080p60 的像素时钟约 148.5 MHz,远在 JFM7K410T 这类器件的时序余量之内。同样的逐像素工作交给 CPU,是每帧几毫秒到几十毫秒的指令循环;交给 FPGA,是固定的几十个时钟周期延迟。
角色 3:缺陷检测(模板、差分、连通域)
模板匹配、图像差分、阈值分割、连通域分析、形态学处理,都是可并行、可流水化的运算。一张 1080p 图像的模板匹配在 FPGA 上可以做到单帧 1ms 以内,且时延与帧率无关、可完全确定——这对产线节拍是硬指标。
角色 4:结果输出与 IO 联动
判定结果直接驱动剔除信号、报警灯、统计计数。FPGA 的 GPIO 输出延迟是纳秒级,不需要经过操作系统、驱动、应用层的中转。缺陷一出现,剔除信号就已经到达执行机构。
三、两种算法路线:传统视觉与深度学习
“上深度学习”是近两年视觉项目的口头禅,但要分清两种路线的实时性边界:
| 维度 | 传统视觉(模板/差分/形态学) | 深度学习(CNN/YOLO 类) |
|---|---|---|
| 1080p 单帧时延 | <1 ms(FPGA 流水线) | 2–10 ms(GPU)或更高(通用 NPU) |
| 资源占用 | 少量 LUT/DSP | 大量 DSP + 外部存储带宽 |
| 可解释性 | 阈值可调、缺陷可溯源 | 黑盒,难定位误判原因 |
| 适用场景 | 缺陷模式固定、节拍快的产线 | 缺陷模式复杂、样本多样的离线复检 |
| 在 FPGA 上实现 | 成熟、工程化程度高 | 需量化剪枝,通常放 CPU/GPU 侧 |
2026 年产线的主流架构是 FPGA 前处理 + 传统算法实时判定 + 深度学习离线复检:FPGA 保证节拍内完成判定与剔除,深度学习负责对可疑区域做二次确认,两者各干各擅长的事。
四、一个真实案例:PCB 焊点 AOI 工位
工程案例 · 01:SMT 产线焊点检测——60fps 连续检测,误检率 < 0.5%
某 SMT 产线 AOI 工位需要检测虚焊、连锡、缺件三类缺陷,60fps 连续检测,误检率目标 < 0.5%,虚焊漏检率 < 1%。
- 相机: 2 台 GigE 2000 万像素工业相机,实际取 1080p ROI 区域,8bit Bayer 输出
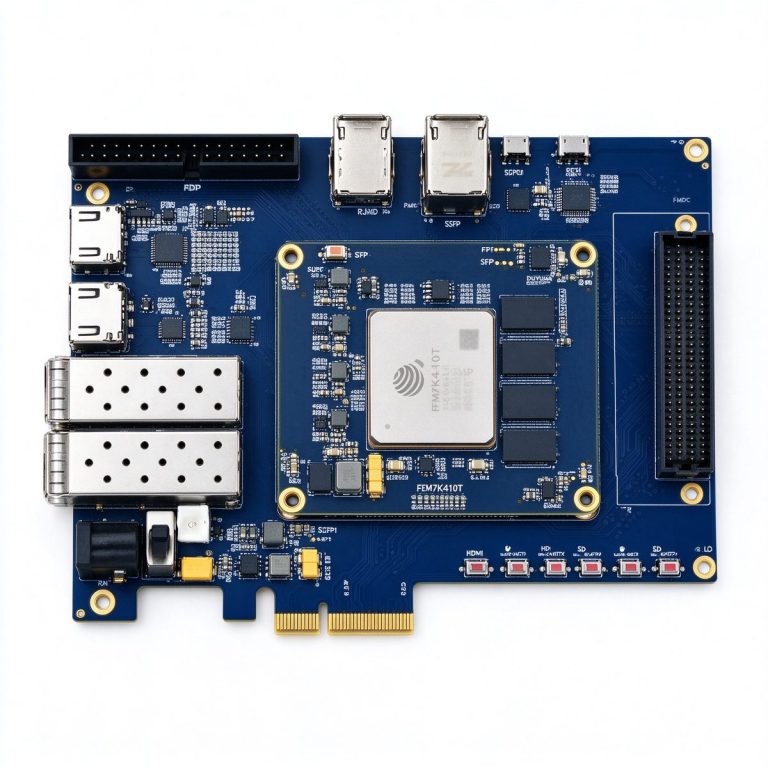
- 板卡: DUK7410T(复旦微 JFM7K410T,406K 逻辑单元,FMC HPC,4GB DDR3)
- 数据流: 2 × 995 Mb/s ≈ 2.5 Gb/s 进 FPGA → DDR 帧缓冲 → 模板差分 + 连通域分析 → 判定输出
实测结果: 单帧处理 < 0.8 ms;从相机触发到剔除信号输出的端到端时延 < 1.5 ms;误检率 < 0.5%,虚焊检出率 > 99%。
对比 CPU 方案: 端到端时延从约 15 ms 降到 < 1.5 ms,主机 CPU 占用从 85% 降到 5%——原来的软件方案只能做到 30fps,换 FPGA 后直接翻倍。
这个工位的关键不是算法多高级,而是检测动作跟得上产线节拍。缺陷帧一出现,下一帧到来之前必须完成判定和剔除动作。
五、硬件怎么选:三款板卡的搭配思路
选型按三个问题走:几路相机?时延要求多硬?整机成本多少? 对应笃远三款常用平台:
DUK7410T(¥9,999)——中端主力,单/双相机 AOI 的标准选择
复旦微 JFM7K410T,406K 逻辑单元、1,540 DSP、FMC HPC、HDMI 4K 输入、2×SFP+。FMC HPC 直连高速相机或 ADC 子卡,HDMI 4K 输入可以同时做显示环回。视觉定位、缺陷检测、多路拼接原型,绝大多数项目从这块板起步。
PBC7K325G(¥1,999)——成本敏感的设备内嵌方案
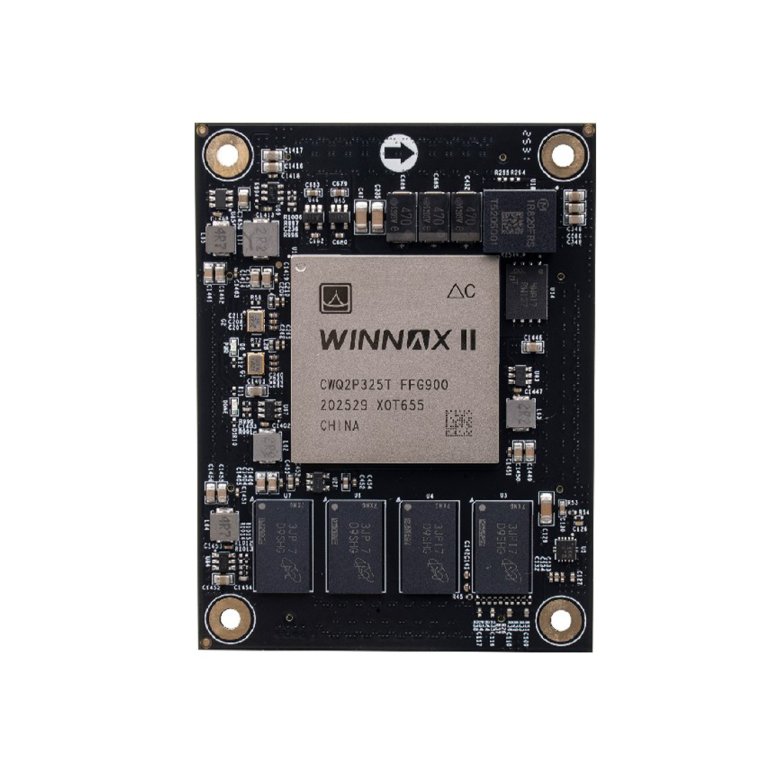
国产 Kintex-7 架构核心板,326K 逻辑、16 路 GTX、2GB DDR3,工业级 -40~85℃。单路相机 + 固定缺陷模式的设备内嵌,或者做视觉 + 运动控制的复合控制器,成本敏感型产品从这里出。
DUF7690T(¥24,999)——多相机阵列与高性能复合系统
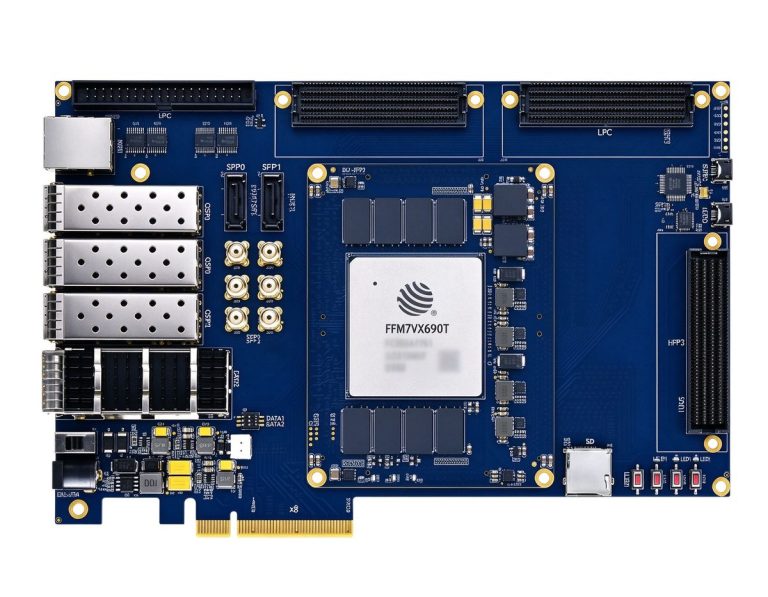
复旦微 JFM7VX690T,693K 逻辑单元、3,600 DSP、36 对 GTH、QSFP 40G。8 路以上相机阵列、8K 拼接、或视觉 + 光纤通信复合系统,需要大逻辑和大带宽时上这块。
工业视觉的第一性原理,是”别把整帧图像搬来搬去”——在像素流过的地方把像素处理掉,时延、带宽、功耗的问题会同时消失。
>
—— 笃远电子研发团队