视频编解码 IP 怎么评估:H.264/H.265 硬编与软编的带宽、延迟、画质账
做视频项目绕不开编解码:四路 1080p 拼接后要推流、相机阵列要回传、机器视觉要存盘。选硬编 IP 还是软核?码率压到多少不糊?延迟能不能压到一帧以内?这篇把硬编与软编的带宽、延迟、资源代价算成一笔账,给选型时一个可落地的判断框架。
先分清:硬编 IP、软核编解码、CPU/GPU 软编不是一回事
FPGA 做视频链路,编解码有三条路线,资源占用和延迟差一个量级:
| 路线 | 实现方式 | 资源占用 | 延迟 | 典型场景 |
|---|---|---|---|---|
| 硬编 IP | FPGA 内嵌硬编引擎(Xilinx VCU / 厂商硬编核) | 几乎不占逻辑单元 | 低(1–3 帧) | 多路 1080p/4K 实时编码推流 |
| 软核编解码 | RTL 写的编解码 IP(占 LUT/BRAM/DSP) | 高(单路 1080p 占 30%+ 逻辑) | 中(3–8 帧) | 没有硬编、需要定制算法 |
| CPU/GPU 软编 | ARM/PS 核跑 x264/x265 软件编码 | 占 CPU 核,不占 FPGA 逻辑 | 高(10 帧以上) | 非实时、离线转码、路数少 |
关键判断:如果你的 FPGA 带硬编引擎(如 Zynq UltraScale+ 的 VCU),优先用硬编;没有硬编的纯 FPGA(如 Kintex-7/Virtex-7 级别),多路实时编码才考虑软核 IP,单路非实时直接走 CPU 软编。
第一笔账:带宽(码率怎么选才不糊)
编解码的输出是码流,码率直接决定存储和传输带宽。先算清楚四路视频要吃多少带宽:
H.264 1080p@30fps 典型码率对照:
| 画质档位 | 单路码率 | 四路总码率 | 4K 单路 |
|---|---|---|---|
| 低画质(监控级) | 2 Mbps | 8 Mbps | 8 Mbps |
| 中画质(工程级) | 4–6 Mbps | 16–24 Mbps | 16–20 Mbps |
| 高画质(展示级) | 8–12 Mbps | 32–48 Mbps | 30–40 Mbps |
H.265 比 H.264 省约 40–50% 码率:同样画质下,H.265 四路 1080p 中画质约 10–12 Mbps,4K 单路约 10–12 Mbps。
工程经验:机器视觉/工业检测场景,H.264 4 Mbps 足够看清细节;展示屏/展厅场景,H.265 8 Mbps 起。别一上来就拉满 20 Mbps——存储和回传带宽会爆。
第二笔账:延迟(什么时候硬编才有意义)
实时视频对延迟敏感:工业相机要闭环、远程操控要跟手、低延时推流要压到一帧以内。
| 环节 | 硬编 IP | 软核编解码 | CPU 软编 |
|---|---|---|---|
| 编码延迟 | 1–2 帧(33–66ms @30fps) | 3–6 帧(100–200ms) | 10–30 帧(300ms–1s) |
| 解码延迟 | 1 帧内 | 2–4 帧 | 5–10 帧 |
| 端到端(含传输) | <100ms | 200–400ms | 500ms+ |
如果是远程操控/手术导航/工业闭环,硬编是唯一选择——软编和软核的延迟根本跟不上。如果是事后存盘回放,软编足够,不用花逻辑资源。
第三笔账:资源代价(软核到底吃多少逻辑)
没有硬编引擎的 FPGA 做实时编码,软核 IP 到底吃多少资源?以单路 1080p@30fps H.264 编码为例:
| 资源项 | 占用量(单路 1080p H.264 编码) | 占 XCKU15P 比例 | 占 DUK7325T 比例 |
|---|---|---|---|
| LUT 逻辑单元 | ~80K | ~15% | ~40% |
| BRAM | ~6 Mb | ~10% | ~25% |
| DSP | ~120 | ~10% | ~30% |
关键结论:单路 1080p 软编在 XCKU15P(Kintex UltraScale+)上还能扛,四路同时编就吃到 60%+ 逻辑;DUK7325T(Kintex-7 级别)单路软编就已经吃掉四成资源,多路必须上硬编或换 CPU 软编。
硬编 IP 的真实瓶颈:不是算力,是配置
带硬编引擎的 FPGA(如 Zynq UltraScale+ VCU),编码能力是固定的——支持几路 1080p、几路 4K 是硬件写死的。真正的坑在配置:
1. 码率控制模式:CBR(恒定码率)适合传输,VBR(可变码率)适合存储;选错会导致画面糊或带宽爆。
2. GOP 长度:GOP 越长压缩率越高,但随机访问和 seek 越慢;监控场景 GOP 2–4 秒,直播场景 GOP 0.5–1 秒。
3. B 帧:开 B 帧省码率但加延迟;低延时场景关掉 B 帧,码率会涨 20–30%。
4. 分辨率切换:硬编引擎切换分辨率要重新初始化,不能像软编那样动态切。
硬编不是”配好就完事”——码率控制、GOP、B 帧这三个参数直接决定最终画质和带宽,调试时要对着实际画面调,不能拍脑袋。
选型决策:什么时候选哪条路线
把上面三笔账合起来,按场景选:
| 场景 | 推荐路线 | 理由 |
|---|---|---|
| 多路 1080p 实时推流(≥4 路) | 硬编 IP | 延迟低、不占逻辑、多路并行 |
| 单路 4K 展示屏 | 硬编 IP(H.265) | 4K 软编吃资源太多 |
| 机器视觉存盘回放 | CPU 软编(H.264) | 非实时,省 FPGA 逻辑 |
| 没有硬编的纯 FPGA + 多路编码 | 软核 IP + 降分辨率 | 逻辑不够就降路数或降分辨率 |
| 远程操控/低延时闭环 | 硬编 IP(关 B 帧) | 延迟必须压到一帧以内 |
板卡选择建议:编解码项目怎么选板子
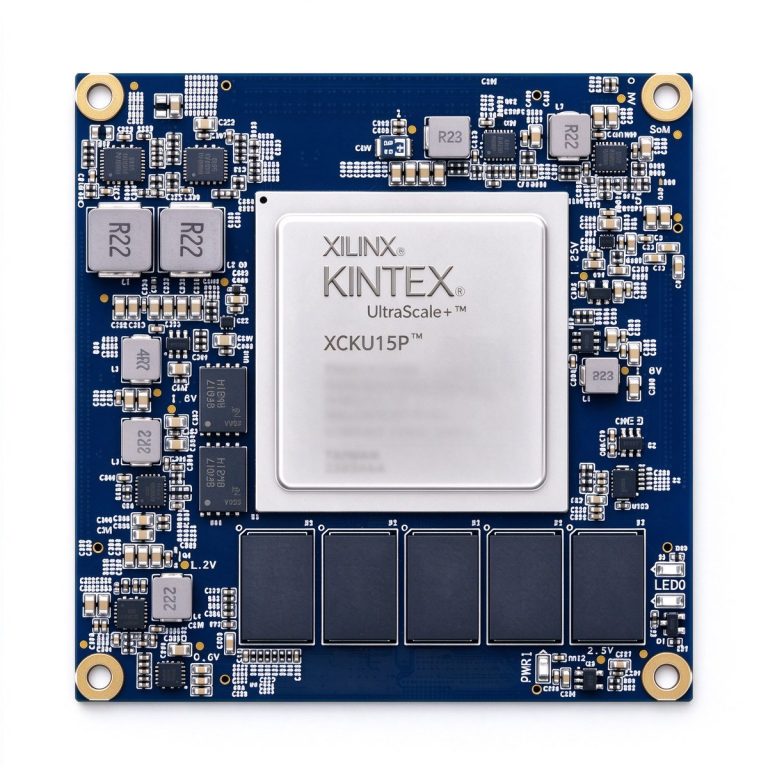
- XCKU15P 核心板(DUKU15P):Kintex UltraScale+ 大逻辑资源,适合多路软核编解码或高带宽视频链路,逻辑余量足。
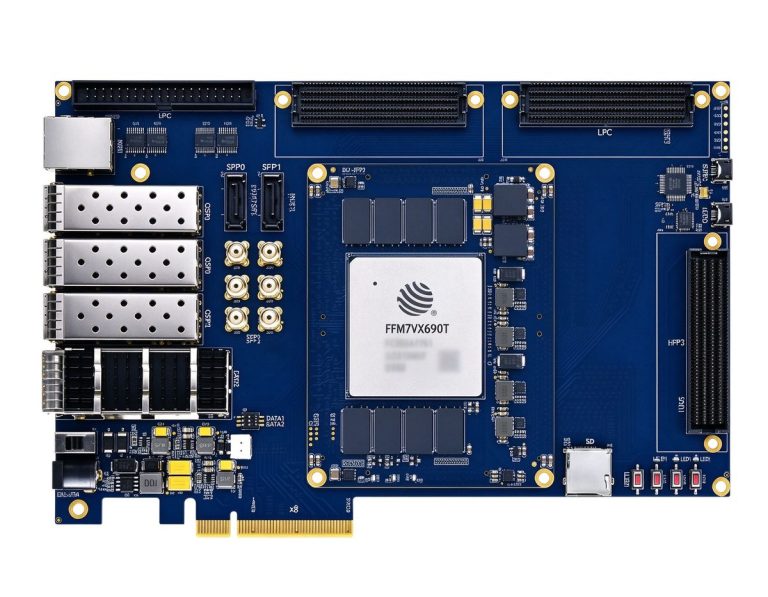
- DUF7690T(复旦微 JFM7VX690T):国产 Virtex-7 级别,资源大,适合国产化项目里的视频编解码链路。
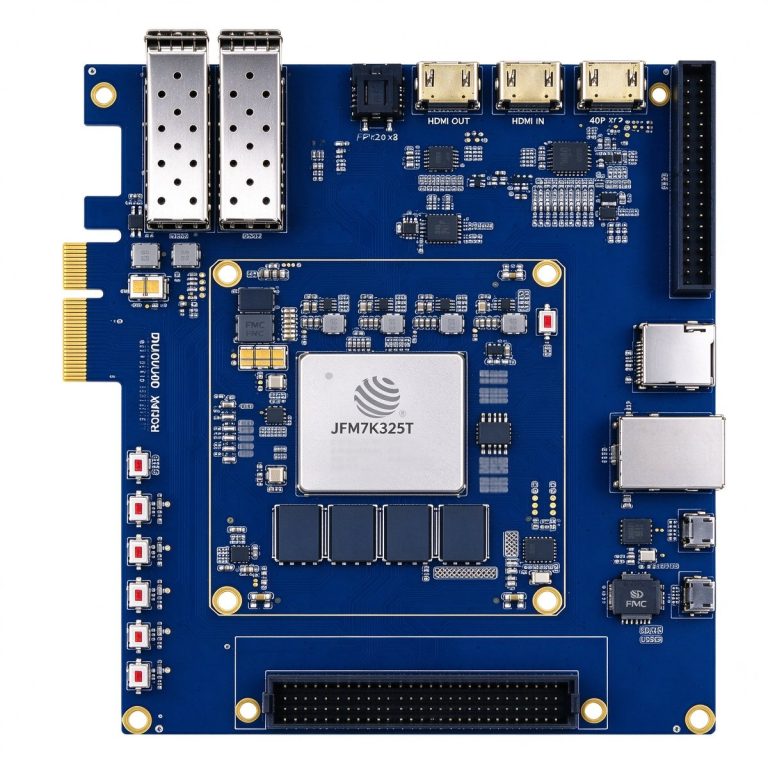
- DUK7325T(复旦微 JFM7K325T):国产 Kintex-7 级别,资源中等,适合单路编码或非实时场景,成本敏感项目。
编解码选型的核心不是”哪个 IP 性能最强”,而是”你的场景需要几路、什么分辨率、延迟要求多少”——先定场景参数,再倒推带宽、延迟和资源代价,最后选硬编还是软编。别反过来先选 IP 再凑场景。
延伸阅读
- [四路 1080p 拼接与 4K 输出:FPGA 视频链路实战](/article/four-channel-1080p-4k-output/)
- [PCIe 带宽规划:DMA、DMA 引擎与多路数据怎么分](/article/pcie-bandwidth-planning/)
- [10G/25G 光纤回传:裸光纤链路与 FPGA 光口对接](/article/10g-25g-fiber-backhaul/)