VU13P 在量化交易中的应用:从行情解码到订单执行的低延迟硬件平台
量化交易的本质,是在最短时间内完成”行情到达—信号计算—订单发出”的完整信息闭环。本文以 AMD Virtex UltraScale+ XCVU13P(VU13P)平台为主线,拆解它为什么适合量化交易,以及如何落地到一条可交付的低延迟交易链路。
量化交易的本质,是在最短时间内完成”行情到达—信号计算—订单发出”的完整信息闭环。在交易所撮合引擎的微秒级时间尺度下,延迟本身就是成本:晚一个微秒成交,意味着价格滑点、机会丢失,甚至是整套策略失效。过去十余年,头部自营交易机构逐步把链路中最关键的部分,从 CPU 软件迁移到 FPGA 硬件——行情解码在卡上、订单簿在卡上、策略判断在卡上、订单生成也在卡上。本文以 AMD Virtex UltraScale+ XCVU13P(VU13P)平台为主线,讨论它为什么适合量化交易,以及如何落地到一条可交付的低延迟交易链路。
一、量化交易的延迟结构:为什么答案是 FPGA
一条典型的自动交易链路,从行情报文到达网卡,到订单离开网卡,会依次经过网络协议栈、行情解析、订单簿维护、信号计算、风控检查、订单编码等环节。软件栈中,内核中断、协议栈处理、线程调度、缓存未命中都会引入不可控的抖动;硬件实现则把这些环节变成固定的流水线级数,时延可确定、无中断、无调度。不同实现方式的端到端 tick-to-trade 时延大致如下:
表:tick-to-trade 端到端时延对比(公开资料综合)
| 实现方式 | 典型端到端时延 |
|---|---|
| 普通软件 + 内核网络协议栈 | 10–100 µs |
| 内核旁路软件(DPDK / Onload + 绑核) | 1–5 µs |
| FPGA 全链路(解析 → 策略 → 订单) | 300 ns – 1 µs |
| FPGA 预置触发(模式匹配即发单) | 30–100 ns |
| Layer-1 交换机(纯扇出/复制) | 约 5 ns |
FPGA 的三个特性决定了这个数量级的差距:并行——多路行情、多个策略实例可以在硬件里同时运行,互不争抢;确定——没有中断与调度,每条报文的处理时延固定,这对风控和审计同样重要;就近——光口直接接入 FPGA,跳过 PCIe 与协议栈,报文边收边解。业界公开数据同样印证:有方案的 tick-to-trade 往返时延可做到 100 ns 以内,AMD 与合作伙伴面向 CME 的参考方案将预置触发时延做到 25 ns 级别;国内《计算机应用与软件》2025 年发表的基于 OpenCL 的超低延迟行情加速系统,在 Alveo U50 上实现行情处理最低 678 ns、吞吐 38.4 Gbit/s,相比软件方案性能提升约 12 倍。
二、VU13P 平台能力总览
VU13P 属于 AMD Virtex UltraScale+ 家族,是当前”逻辑规模 × 高速接口”平衡点上的代表器件。根据 AMD 官方产品资料,其关键规格如下:
表:XCVU13P 关键规格(数据来源:AMD 官网 Virtex UltraScale+ 产品页)
| 指标 | XCVU13P 规格 |
|---|---|
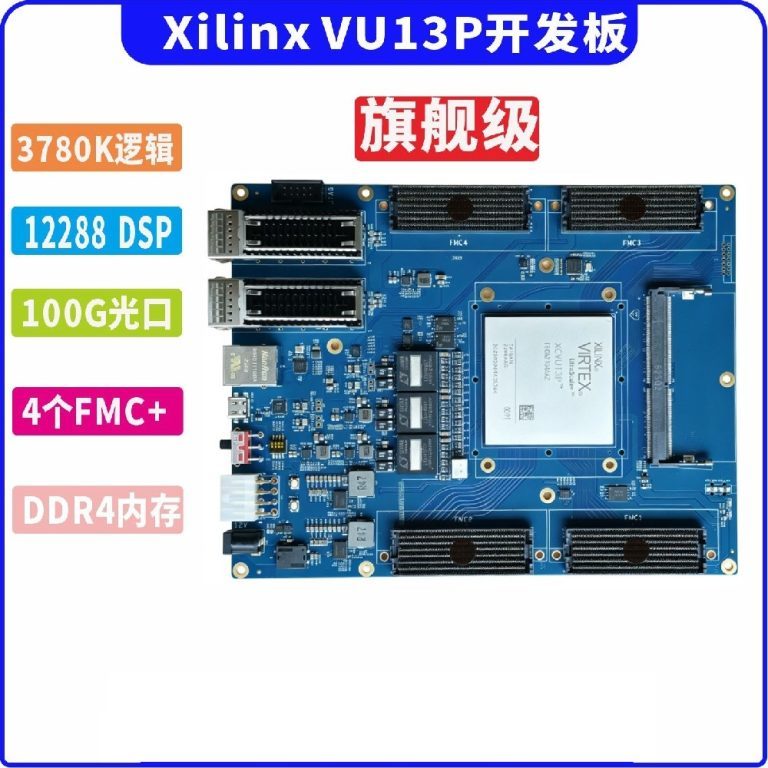
| System Logic Cells | 3,780K(约 378 万逻辑单元) |
| DSP Slices | 12,288 |
| GTY 高速收发器 | 128 对(单对最高 32.75 Gb/s) |
| 用户 I/O | 832 |
| 集成高速接口 | PCIe Gen3 x16、100G Ethernet MAC、150G Interlaken(片内硬核) |
| DSP 算力 | 最高约 38 TOP/s |
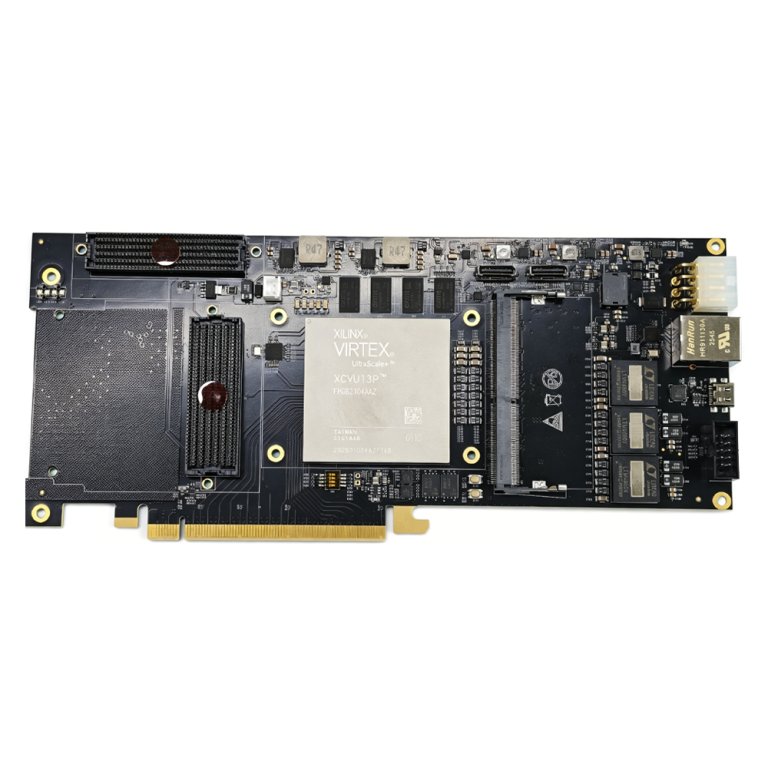
落到板卡层面,笃远电子的 VU13P 超高端开发平台提供 PCIe Gen3 x16 金手指、多路 100G 光口(QSFP28)、FMC+ 高速扩展、DDR4 SODIMM 扩展与工业级 -40℃~85℃ 温度范围。对量化交易而言,这张板卡天然具备三件事:把多路交易所行情直接接入 FPGA(光口 + GTY)、把大量策略逻辑放进 FPGA(378 万逻辑单元 + 12,288 DSP)、与主机保持高带宽双向互联(PCIe Gen3 x16)。
三、VU13P 在量化交易链路中的四大核心应用
3.1 行情解码与数据预处理(Feed Handler)
交易所的行情协议(如 NASDAQ 的 ITCH、CME 的 MDP3、欧交所常用的 FAST 等)以极高的报文速率到达,软件解析需要逐条解码、校验、重建结构体,是链路中最早、也最典型的瓶颈。在 VU13P 上,行情解析以硬件流水线实现:报文从光口进入后按字节流边收边解,字段提取、校验和协议重组在固定的流水级内完成,多路行情(多交易所、A/B 主备线路)可并行处理。128 对 GTY 收发器与多路 100G 光口提供了充足的同时接入能力;对采用主备双线路发布的交易所(如 CME 的 A/B 线路),还可以在硬件里做线路仲裁与无缝切换,避免单线路抖动造成的行情缺失。解析后的标准行情结构直接写入片上存储,供后续策略模块使用,全程不经过主机 CPU。
3.2 硬件订单簿与并行策略执行
维护一张可查询的订单簿(Order Book)需要频繁的增删改与排序操作,软件实现依赖内存访问和锁,硬件实现则把价格层级直接映射为片上 Block RAM 结构,价格查询与撮合判定在固定周期内完成。在此基础上,VU13P 的 378 万逻辑单元允许在同一片器件上并行运行多个策略实例:不同品种、不同市场、甚至不同策略逻辑(做市、跨市场套利、延迟套利、统计回归)可以各自占用独立的逻辑分区,共享同一份解析后的行情流,互不干扰。对延迟最敏感的触发型策略,可以采用”预置订单”方式:把订单模板预先写入发送缓冲,当硬件检测到设定条件(价格穿透、量比变化)时直接触发发送,跳过软件决策路径,时延可压缩到数十纳秒级。
3.3 预交易风控(Pre-Trade Risk)
交易所与合规体系对算法交易的风控要求日益严格:价格带宽、单笔数量上限、日累计头寸、订单频率等检查必须在订单发出之前完成。软件风控的问题在于它本身就在关键路径上,引入额外时延;FPGA 风控则把检查逻辑并行地挂在订单通路旁——每个订单在硬件流水线中经过若干级风控检查,通过后即刻编码发送,不通过则在纳秒级内拦截。风控规则用寄存器/内存表配置,交易日内可热更新,这既满足合规要求,又不牺牲主链路的低时延。
3.4 回测、仿真与研发加速
除生产链路外,VU13P 的大规模逻辑资源还可以用于策略研发:在开发板上加载行情重放与仿真引擎,对历史行情做硬件级回测,多策略并行跑批,显著快于软件仿真;通过 Vivado/Vitis HLS 把 C/C++ 算法快速映射为硬件实现,缩短”策略想法 → 可测硬件”的迭代周期。典型工程组织方式是”FPGA 跑生产路径、CPU 跑监控与分析”:生产订单与行情处理全在卡上完成,主机通过 PCIe Gen3 x16 读取状态、下发策略参数与风控规则,兼顾性能与运维。
四、典型端到端系统架构
基于 VU13P 的量化交易平台,典型拓扑如下:
- 行情接入:交易所行情经 100G 光口(QSFP28)直接进入 FPGA,128 对 GTY 承载多线路;
- 硬件解析:Feed Handler 模块按协议(ITCH/FAST/MDP3 等)流水线解析、校验、A/B 仲裁;
- 订单簿与信号:片上 BRAM 维护多品种订单簿,策略分区并行计算信号,触发条件成立即生成订单;
- 风控与编码:订单经过预交易风控检查后编码为交易所协议报文,进入发送缓冲;
- 主机互联:订单回报、成交回报、状态监控经 PCIe Gen3 x16 上送主机;策略参数、风控规则由主机下发;
- 扩展接口:FMC+ 用于接入自定义网卡/加速子卡,OCULINK 用于板间高速互联,扩展多板并行。
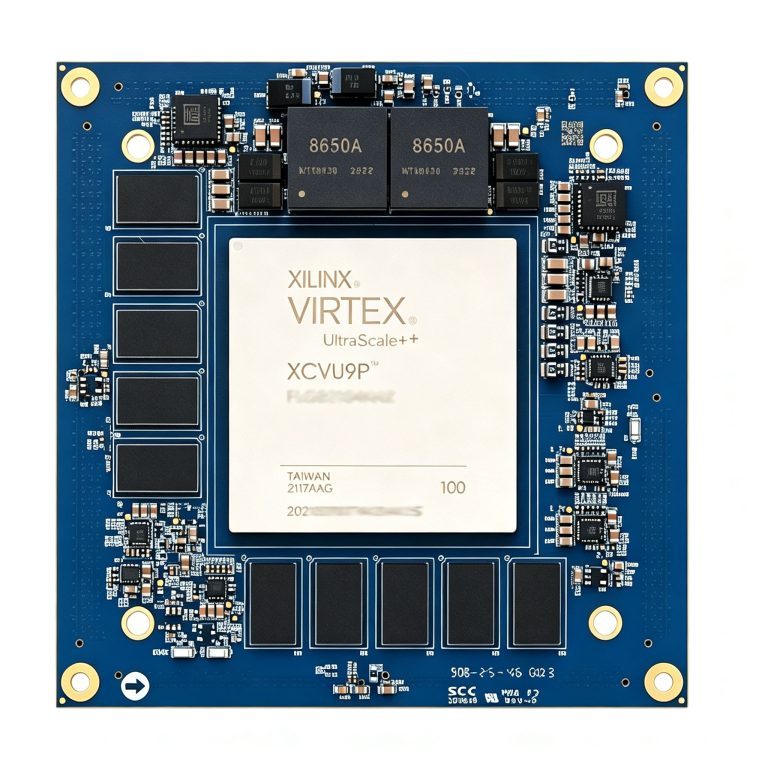
在部署形态上,VU13P 开发板可直接作为服务器内的 PCIe 加速卡使用;对机架空间与功耗敏感的场景,可基于该平台定制更低功耗的核心板形态。
五、VU13P 相比其他方案的工程优势
表:量化交易硬件平台对比视角
| 维度 | VU13P(FPGA)相对优势 |
|---|---|
| 端到端时延 | 全链路 300ns–1µs,预触发 30–100ns;软件方案通常为 1–100µs |
| 时延确定性 | 流水线级数固定,无中断/调度抖动,利于风控与审计 |
| 并行容量 | 3,780K 逻辑单元 + 12,288 DSP,多策略/多品种同时运行 |
| 接口带宽 | 128×GTY、多路 100G 光口、PCIe Gen3 x16,多交易所行情直连 |
| 灵活性 | 可重构:策略变更改配置/重加载,不需要换板卡;相比 ASIC 开发周期短得多 |
| 开发门槛 | 相对 ASIC 低;可用 Vitis HLS/OpenCL 从 C/C++ 映射,关键路径再以 RTL 优化 |
对比 CPU:VU13P 在时延与确定性上高出一个数量级;对比 GPU:GPU 擅长批量吞吐,但流水线与调度带来的时延抖动使其不适合纳秒级关键路径,而 VU13P 的确定时延天然匹配;对比 ASIC:ASIC 性能最优但一次性成本与开发周期高企,只适用于完全固化的算法,VU13P 则保留了策略演进的灵活性。这也是自营交易机构普遍把”FPGA 做关键路径、CPU/GPU 做研究与离线计算”作为标准分工的原因。
六、开发与落地要点
- 工具链分工:关键路径(协议解析、订单编码)用 RTL 保证时延;策略逻辑可用 Vitis HLS / OpenCL 快速实现,先用软件仿真验证行为,再综合到硬件;
- 模块化接口:Feed Handler、Order Book、Strategy、Risk、Gateway 之间统一使用 AXI-Stream 数据接口,便于替换、复用与多人协作;
- 时钟与同步:多板/多站点部署时引入 PTP/1PPS 与低抖动时钟树,统一时间基准,保证成交回报与行情时戳对齐;
- 从标准板起步:先在 VU13P 开发板上完成行情解析与策略验证,跑通延迟链路,再按项目需求定制板卡形态(接口数量、功耗、结构);
- 监测与回归:硬件逻辑上保留统计计数器与 ILA 观测点,交易日内监控每级流水时延,任何恶化可快速定位。
七、局限与选型建议
FPGA 不是所有量化场景的答案。如果策略以分钟级、小时级调仓为主,或依赖大规模机器学习特征与频繁迭代的复杂模型,CPU/GPU 软件栈的成本与灵活性优势更明显;如果团队缺乏硬件开发能力,FPGA 项目的评估、调试与维护周期需要充分预估。在确定需要硬件低延迟的前提下,器件选型可以按资源需求分层:
- VU9P:2,586K 逻辑单元、6,840 DSP,配合 2×200G + 4×100G 光口、32GB DDR4 ECC、PCIe x16——适合行情接入量大、以存储与带宽见长的场景;
- VU13P:3,780K 逻辑单元、12,288 DSP、128×GTY——适合多策略并行、策略逻辑复杂、需要更大片上资源的场景,是本类应用的综合主力平台;
- VU13F:同样 12,288 DSP,4×FMC+ 提供大量可扩展 I/O 与子卡接口——适合需要连接自定义网卡、射频前端等外部硬件的系统级集成。
注:文中时延数据为公开资料口径的典型区间,实际数值与协议、报文速率、策略实现与板卡走线相关,选型与验收建议以实测为准。
八、结语
量化交易的硬件化是持续多年的确定性趋势:从最早的网卡卸载,到行情解析与订单链路整体搬上 FPGA,再到今天一块 VU13P 级别的器件同时承载多市场行情、多策略与风控。VU13P 的价值在于它把”规模”和”速度”放在同一片器件上——足够大的逻辑与 DSP 让复杂的策略组合可以在硬件里并行,足够多的 GTY 与 100G 光口让多交易所接入不再是瓶颈。笃远电子提供 VU13P / VU9P 标准开发板、定制核心板、行情解码与低延迟链路 IP 配套及全程技术支持,可帮助团队从评估板验证快速走到可部署的量化交易硬件平台。
参考资料
- AMD,Virtex UltraScale+ FPGA 产品页(XCVU13P 规格):https://www.amd.com/en/products/adaptive-socs-and-fpgas/fpga/virtex-ultrascale-plus.html
- AMD/Xilinx 与 LDA,CME Tick-to-Trade 25 纳秒参考方案:https://www.xilinx.com/publications/solution-briefs/partner/xilinx-lda-amd-tick-to-trade-solution-brief.pdf
- libfpga,FPGAs in high-frequency trading: the anatomy of a nanosecond(tick-to-trade 延迟对比):https://libfpga.com/blog/fpgas-for-hft
- semidesignjobs,FPGAs in High-Frequency Trading: A Technical Deep Dive:https://www.semidesignjobs.com/blog/fpga-hft-technical-deep-dive
- Enyx,nxFramework(sub-100ns tick-to-trade 平台):https://www.enyx.com/nxframework/
- 《计算机应用与软件》2025,基于 OpenCL 的超低延迟行情加速系统设计与实现:https://shcas.net/cn/article/doi/10.3969/j.issn.1000-386x.2025.03.003
- ACM,DSL Programmable Engine for High Frequency Trading Acceleration(FAST 协议加速):https://dl.acm.org/doi/pdf/10.1145/2088256.2088268
笃远电子 · 应用实践 | 数据截至 2026 年 9 月,不同机构口径存在差异,已逐一标注